

Bring your own expert! MoE-Modelle um neues Fachwissen erweitern
16. November 2026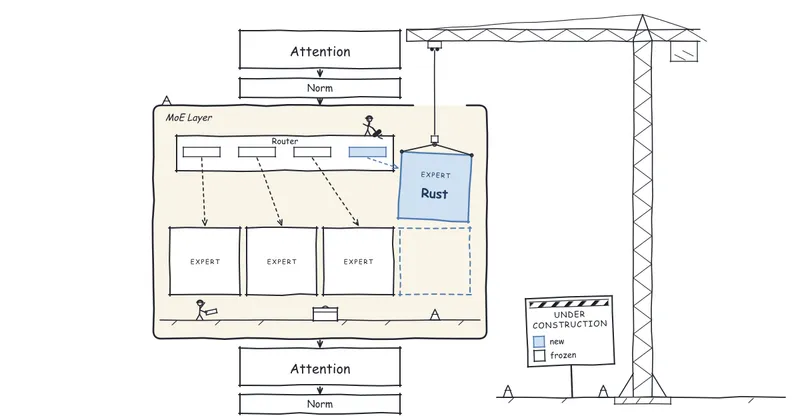
Viele der heutigen State-of-the-Art-LLMs nutzen eine Mixture-of-Experts-Architektur (MoE): Statt eines einzigen monolithischen „Gehirns" besteht das Modell aus vielen kleinen Teilnetzwerken, sogenannten „Experten", von denen pro Token nur ein Bruchteil aktiviert wird.
Unser TNG KI-Forschungsteam sucht weiterhin nach Wegen, große Sprachmodelle effizient anzupassen. Also haben sie sich gefragt: Können wir unsere eigenen Experten trainieren und einfach in ein bestehendes Modell einfügen?
Die Antwort finden Sie in unserem neuesten Artikel auf Hugging Face.